YES娛樂3月28訊:
3月26日,崑崙萬維正式釋出Mureka V6模型與Mureka O1模型。Mureka O1作為全球首款音樂推理大模型,多項效能超越Suno V4、登頂SOTA,中國的AI科技公司再次實現DeepSeek時刻,引領AI音樂革命!
去年4月,崑崙萬維釋出第一代音樂生成模型Mureka V1(SkyMusic)。經過近一年升級迭代,Mureka V6、Mureka O1大模型已全量上線。Mureka是全球首批開放API服務的高質量AI音樂生成平臺,將為全球開發者或音樂平臺提供頂尖的AI生成音樂能力。
崑崙萬維比國內大多數大廠入局AI音樂賽道的時間更早,並且早已將AI音樂視為一個核心競爭方向。Mureka O1的出現,為AI音樂乃至AI應用快速走向商業化提供了一個絕佳範本——達到技術SOTA,向全球市場提供多樣化的API服務,兼顧C端使用者需求,從而享有更大範圍的SOTA紅利。
近期,崑崙萬維董事長兼CEO方漢接受了財聯社專訪。方漢表示,崑崙萬維在音樂資料層面已有七八年的積累,在模型和演算法迭代方面的工作則始於2021年。Mureka O1如今已取得全球AI音樂SOTA,正是技術和產品雙輪驅動造就了崑崙萬維的護城河,這種技術先進性不僅真正降低了使用者創作門檻與成本,亦將轉化為面向全球市場的商業化紅利,預計為崑崙萬維AI業務商業上的成功帶來重要加持。
方漢稱,AI產業正向實用化、產品化高速迭代,崑崙萬維將關注AI長期發展,致力於在全球範圍內落地更多更好的AIGC應用, " Mureka降低了使用者的創作門檻、創作成本,我覺得是非常有意義的,不僅能讓每個人更好地用音樂來塑造和表達自我,也將帶來全球各個國家內容創作領域的極大爆發。"
加碼AI音樂生成賽道背後,是崑崙萬維在AIGC領域多年的佈局——自2020年開始佈局AIGC領域,組建近百人研發團隊;2022年12月15日,在ChatGPT尚未在國內現象級“出圈”時,崑崙萬維就率先發布「崑崙天工」,彼時其AI內容生成能力就已覆蓋文本、影像、音樂、程式設計等全模態;2023年初ChatGPT熱潮真正席捲全球之時,崑崙萬維已是國內為數不多的全面佈局AIGC領域的重要玩家,釋出自研的「天工 1.0」雙千億級大語言模型。
人工智慧發展日新月異,過去兩年崑崙萬維始終堅持大模型迭代和AI應用並行,天工大模型從1.0升級到4.0,AI應用層則是搜尋、遊戲、短劇、音樂等場景全面開花,出自崑崙萬維之手的中國首個音樂SOTA模型Mureka V1(SkyMusic)、全球首個整合影片大模型與3D大模型的AI短劇平臺SkyReels在業界均具備首創性。
據悉,Mureka V6是當前Mureka的基座模型,支援純音樂生成,還支援10種語言的AI音樂創作,包括英中日韓法西葡德意俄,覆蓋世界上大多數國家和地區,瞄準的正是AI的國際化路線。在Mureka V6中,團隊引入自研 ICL(in-context learning)技術,使得聲場更加開闊,人聲質感和混音設計進一步強化。
Mureka O1模型則是基於Mureka V6的思維鏈推理最佳化版本,也是全球首個引入CoT(Chain-of-Thought)的音樂模型,在推理過程中加入思考與自我批判,顛覆性提升音樂品質、音樂創作效率和靈活性。此外,Mureka還提供"以歌曲為prompt"、"音色克隆"兩大特色音樂生成功能。
值得關注的是,Mureka O1中包含的音樂生成領域創新研究成果MusiCoT,具備技術領先性和前瞻性。由於當前業界關於音樂領域的演算法工作非常少,僅少數幾個團隊公開了工作成果,崑崙萬維此次以論文形式公開了Mureka O1的實現原理。
專案主頁:MusiCoT.github.io
以下為採訪實錄:
Mureka O1取得全球AI音樂SOTA
財聯社:我試用了一下MurekaV6&O1,生成的歌曲音色很標準,支援多種語言生成歌曲,功能十分新穎。想了解下,此次Mureka V6&O1模型的創新亮點有哪些?
方漢:首先,Mureka V6 支援純音樂生成,同時也支援10種語言的AI音樂創作,包括中英葡西日韓德法俄意等,已經涵蓋了全球人口的將近90%,在全球化的意義上也是非常重要的;Mureka O1大部分指標跟海外的Suno持平,但在部分關鍵性指標如人聲、背景音樂混音等方面領先於Suno。
其次,Mureka是全球首批開放API服務的AI音樂生成平臺,我們面向企業和開發者開放兩大類靈活的API服務,不僅包括音樂音訊生成API,還有語音合成API,涵蓋的場景非常多樣化。
其中,音樂API包括標準音樂生成API、精調私有曲庫API,適用於內容創作、遊戲配樂、短影片等多場景應用,還能定製品牌音樂、個人專輯等專屬內容;語音API包括語音播客、精品說話人、音色克隆等 API ,用於語音播客、預製精品音色語音合成、音色克隆等場景。
值得一提的是,我們還開放了微調API服務,開發者可以拿私有資料來微調模型,可以讓模型生成符合其長尾資料特徵風格的歌曲,因為我們這個模型畢竟是用常見樂器、常見旋律、常見風格來訓練的。比如某個國家有一種特殊的樂器,它的音色可能之前沒有被收錄,使用者將這部分資料上傳之後就可以進行模型微調。這對於專業音樂人或工作室來說,作用是非常重要的。
另外,Mureka生成的音樂還能夠進行音軌分離,把人聲伴奏及每個樂器都按照不同的軌道輸出,方便使用者後續進行混音與二次創作。
總而言之,我們的創新亮點非常多,也是非常注重國際化和長尾需求,能夠讓全世界使用者用更低的門檻、更低的成本來進行音樂創作。
財聯社:Mureka的核心使用者群體是哪類人群?目前取得了怎樣的效果?
方漢:我們的使用者包括所有對音樂創作有需求的人,包括泛音樂人群,不只是專業的音樂從業者。
舉個例子,飯館需要放背景音樂,之前可能是要用比較不菲的價格購買商業音樂,現在可以用我們的產品製作飯店專屬的音樂。同時,獨立遊戲開發者、影視創業者也可以跳過原來外包的音樂生產形式,帶來成本的降低。 目前已經有超過 100 個國家和地區的使用者訪問Mureka。
財聯社:目前國內有海綿音樂,國外有Suno,但整體上國內外還沒看到太多AI音樂相關的產品。按照目前的技術水平,Mureka是否已經取得了這個行業的SOTA地位?
方漢:我們已經達到了全球AI音樂領域的SOTA。
第一,我們在音樂資料上已經有了將近七八年的積累。此前我們收購了美國音樂社交公司Star Goup,獲得了超過200萬首的授權曲庫,後來我們逐漸將核心產品StarMaker打造成為海外音樂社交領域的頭部,在東南亞及中東地區優勢穩固,同時在拉丁美洲及歐洲主要市場躋身第一梯隊,歷史註冊使用者3.1億。中國有這樣經驗的公司並不多。
第二,模型和演算法的迭代上,我們從2021年開始對音樂模型進行了多次迭代,在AI音樂生成領域的每個方向都進行過認真的探索和嘗試。
同時,我們也注意引入文本大模型裡面的先進技術,比如Mureka O1首次在音樂生成領域應用CoT技術,通過逐步反饋與最佳化機制,顯著提升了歌詞旋律契合度、演唱準確性和藝術表現力,同時保持了低延時音樂生成。
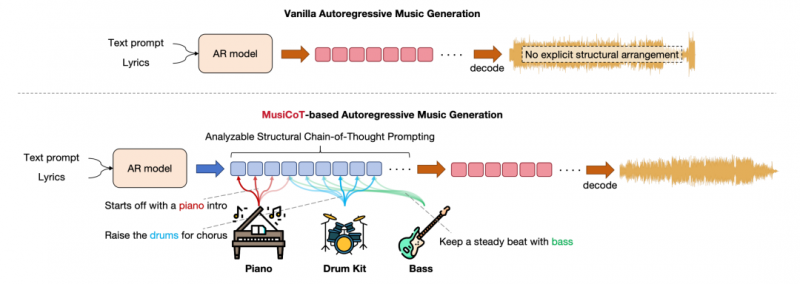
圖丨Mureka自研基於MusiCoT的自迴歸模型音樂生成技術(來源:MuisCoT.github.io/)
另外,Mureka O1還能保持非常高效的推理效果,推理速度比競品可能要快一倍以上。
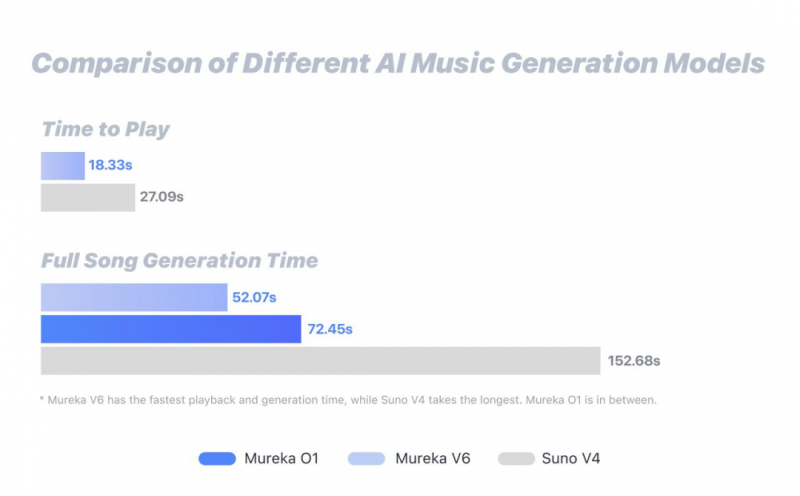
圖丨Mureka O1實現了行業領先的低延時音樂生成
整體而言,Mureka O1的技術壁壘非常高。
財聯社:兼具稀缺性和有趣,Mureka將來有希望成為“Killer App”麼?
方漢:我覺得在音樂賽道,Mureka成為Killer App是毋庸置疑的。
財聯社:如果未來3-5年AI音樂行業技術出現顛覆性突破,崑崙萬維將如何保持核心競爭力?
方漢:我覺得還是要雙輪驅動,首先技術上要保持領先,我們有大量的音樂資料,在模型側也有長期的研發積累,我們一定會繼續向前,不斷迭代;在產品上,我們也會進行產品上的大量創新,不斷探索如何讓普通人更好地利用我們的工具來生產更好的內容,在這方面我們可以做的工作也很多。
基於技術和產品雙輪驅動,我相信我們的護城河也會越來越深。我們對於音樂賽道可能比大廠還要更加專注,因為這是我們的一個核心競爭方向,所以我們非常有信心在長期的競爭中取得最後的勝利。
AI音樂的API商業化已進入爆發前夜
財聯社:此次Mureka O1上線,是否音樂創作是崑崙萬維比較看重的一個細分領域?為何比較看重這個細分領域?
方漢:我們非常看好音樂生成這個領域。
公司的口號是「實現通用人工智慧,讓每個人能夠更好地塑造和表達自我」,第一句話是說AGI——所有人的長期目標,第二句話實際上指的是AIGC,即內容生成賽道。
AIGC指AI生成繪畫、音樂、音訊、影片等領域,所有這些內容創作在AI介入之前成本較高。舉個例子,原來一個公司採購一首曲子,要找人作曲、找樂隊演奏、找混音工作室用硬體裝置混成最終的曲子,單首曲子的報價大概十萬元人民幣,在Mureka出現之後,我們可以把單首曲子的創作成本降到幾塊錢甚至幾分錢。這樣的結果是:降低了所有人創作內容的門檻。
讓每個人更好地塑造和表達自我這件事情,我們覺得非常有意義。不僅降低了使用者創作門檻、創作成本,也將帶來全球各個國家內容創作領域的極大爆發。
同時,我們因為出海比較早,我們有海外音樂社交產品StarMaker,每天有600萬人在上面唱歌並且分享。作為音樂賽道的一個長期的重要玩家,我們積累了大量的技術經驗和資料,我們從2021年就開始研發Mureka的基座模型,才使得Mureka O1音樂生成大模型終於能夠達到世界第一的位置。
我們相信在音樂賽道技術上的領先,能夠轉為產品和市場上的大量紅利,這是我們非常看重音樂創作這個細分領域的一個重要原因。
財聯社:站在商業化角度,Mureka取得了SOTA地位後,能夠帶來哪些利好?
方漢:只有在技術上達到了SOTA,大量的KOL在使用過產品之後會自發地去宣傳,所有的使用者也會形成一個心智:中國人做的Mureka是目前最好的音樂生成模型,也是目前推理速度最快的、也是能夠定製化生產本地化音樂的模型。取得SOTA地位之後,大量的小語種國家唯一的選擇就是Mureka。
正如前面所說,我們拉低了成本、製作門檻,商業版訂戶也會大幅增長。音樂製作工具是一個每年約40億美金收入規模的市場,但其實製作歌曲的人比聽歌的人要少。但隨著門檻降低,未來Mureka全球潛在使用者群會比之前數字音樂工具市場的使用者群有十倍甚至百倍的增長,這將對我們AI業務商業化有非常大的幫助。
財聯社:我也注意到Mureka提供兩大類靈活的API服務,融合了很多細分場景的實際需求。背後是否意味著有比較大的商業機會?您看到的趨勢是怎樣的?
方漢:我們提供的API面向不同的應用場景,我剛才說的音樂製作工具賽道其實是一個相對窄的賽道,但是提供語音播客API,市場就更廣了,比如Podcast(播客)一年就是一兩百億美金的賽道。
如果把相關合成API都開放給使用者,不管有什麼樣的需求,可能通過Mureka都能得到一攬子的解決方案。比如:智駕場景,車主可以定製專屬座艙音樂;MCN等內容製作公司可通過企業級定製化服務製作短影片、廣告配樂;開發者可以用API做二次開發提供更有趣的音樂教育、音樂陪伴等產品;垂直場景的播客、有聲內容甚至是影視配音領域,都可以用語音合成API支援帶情感的人聲,用於有聲書、虛擬主播等場景。
AI音樂的API商業化已經進入爆發前夜,短期機會是B端效率工具和C端創作平臺,長期則可能衍生出音樂版權區塊鏈、AI作曲師等新業態。
財聯社:Mureka主要面向海外,此前釋出的AI短劇產品SkyReels也是面向海外,崑崙萬維後續是否把海外作為AI的主戰場?
方漢:海外肯定是主戰場。
首先,歐美對於所有付費型產品,包括SaaS付費甚至個人使用者訂閱付費,都已培育了較好的付費習慣;其次,海外不是單一市場,而是多語種混合的市場。對於我們這種在海外從0到1打造了多款千萬級DAU產品的公司,我們在出海方面的經驗非常豐富。
之前的SkyReels等產品進展也是非常快,已經取得了一些成績。我們基本上都是圍繞著通過技術來降低使用者創作內容的門檻和成本,只不過這次Mureka走的是音樂賽道,其他產品走的是社交與影片賽道。
關注AI長期發展,落地更多更好的AIGC應用
財聯社:在您看來,這一波人工智慧浪潮發展演變到了什麼階段?崑崙萬維下一步的整體AI戰略是什麼?
方漢:我認為人工智慧已經到了從實驗室或技術報告,甚至說從ToC大量地向ToB去轉化的階段,有大量的實際落地場景是非常明確的。產業已經向實用化、產品化方面高速迭代,我覺得現在這個階段是令人激動的,因為開始真正創造實際價值了。
正如前面所說,我們的願景和價值觀是「實現通用人工智慧,讓每個人能夠更好地塑造和表達自我」。如果說前半句是指仰望星空,那麼後半句指的就是腳踏實地,落地更多更好的AIGC應用,兼顧商業和技術。
財聯社:年初DeepSeek爆火引出了“AI普惠應用”的一個提法,你們怎麼看這個說法?真正要實現AI普惠應用要跨過哪些難關?
方漢:普惠應用肯定是一個終局,但要實現普惠應用,硬體、軟體以及產品方面都要有大幅創新。
硬體方面,目前成本高昂,同時AI硬體市場應該說是全世界一家獨大。隨著硬體競爭不斷加劇,單位成本會逐漸降低,市場上應該會出現至少3-4家公司互相競爭的局面,這樣才能推進硬體的高速迭代。
軟體方面,軟體演算法的最佳化空間目前遠遠沒有到挖掘殆盡的地步。DeepSeek的最佳化使得推理成本出現十倍甚至百倍下降,我們認為演算法軟體最佳化仍有巨大的空間來降低成本。
產品創新方面,通過產品模式的創新讓大多數人也能免費使用產品,這裡面其實有很多的工作可以做。在中國的遊戲及網際網路應用裡其實已經有很好的產品模式,我相信通過產品模式創新,也能讓更多普通人使用大模型來提升生活體驗,實現AI普惠。
財聯社:崑崙萬維從2020年就開始做AI方向的大模型研發,按照目前的進展,您如何評價公司在整個AI行業中的地位?
方漢:我們屬於一家關注AI長期發展的中型科技公司。跟大廠比,我們的資金沒那麼多,但是更加靈活高效,對於業務的垂類方向也更加專注;跟初創公司比,我們因為是上市公司,也有巨大的現金流,資金充足,不會因為短期融資的困難而動作變形。長期來看,我們可以堅持研發方向,以使用者需求為導向,這樣的話才能真正取得一定的成績。
財聯社:您是否認同“Scaling Law已經放緩”?當前技術路線下,大模型距離“通用人工智慧”還有多遠?
方漢:Scaling Law最早指的是在預訓練階段,人類把所有資料都灌進去,讓大模型去學會,但實際上人類的高質量資料基本上已經用完了。而且算力卡的規模再往上堆疊,訓練成果也沒有明顯的提升。預訓練的Scaling Law肯定已經是大大放緩了。
在OpenAI o1和DeepSeek R1出來之後,推理的Scaling Law也已經出現。在推理側,我們用更長的時間讓模型輸出,能夠提取得更好的效果,推理的Scaling Law現在還在增長中。
但是從長期來看,推理的Scaling Law本質上是讓大模型去學習人類推理的資料,目前大模型僅學習了數學和程式設計的推理資料,對於大量的高質量垂類資料,大模型目前仍然是一個死記硬背甚至沒有掌握的階段。
我認為,大模型在垂類資料以及更多的常識方面,不管是預訓練Scaling Law還是推理Scaling Law,都還有一定的發展空間。